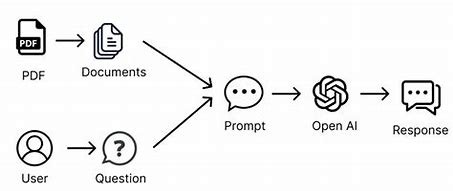
RAG مخفف Retrieval-Augmented Generation (تولید مبتنی بر بازیابی اطلاعات) است. این تکنیک در هوش مصنوعی باعث میشود مدل زبانی قبل از پاسخ دادن، اطلاعات مرتبط را از یک منبع خارجی پیدا کند و سپس بر اساس آن پاسخ تولید کند.
به زبان ساده:
- سؤال کاربر دریافت میشود.
- سیستم در یک پایگاه دانش (مثل PDFها، اسناد، دیتابیس یا ویکی شرکت) جستجو میکند.
- مرتبطترین اطلاعات را پیدا میکند.
- آن اطلاعات را به مدل زبانی میدهد.
- مدل با استفاده از آن اطلاعات، پاسخ دقیقتری تولید میکند.
مثال
فرض کنید از یک چتبات شرکت میپرسید:
«سیاست مرخصی شرکت چیست؟»
- اگر فقط از مدل زبانی استفاده شود، ممکن است اطلاعات قدیمی یا اشتباه بدهد.
- اما اگر از RAG استفاده شود، ابتدا فایل «آییننامه منابع انسانی» را پیدا میکند و سپس پاسخ را بر اساس همان فایل میدهد.
مزایای RAG
- ✅ کاهش خطا و «توهم» (Hallucination) مدل
- ✅ استفاده از اطلاعات بهروز بدون نیاز به آموزش مجدد مدل
- ✅ امکان پاسخگویی بر اساس اسناد اختصاصی سازمان
- ✅ ارزانتر و سریعتر از Fine-tuning برای بسیاری از کاربردها
معماری ساده RAG
کاربر
   │
   ▼
سؤال
   │
   ▼
Retriever (جستجو)
   │
   ▼
اسناد مرتبط
   │
   ▼
LLM (مثل ChatGPT)
   │
   ▼
پاسخ نهایی
تفاوت RAG با Fine-tuning
| RAG | Fine-tuning |
|---|---|
| اطلاعات از بیرون بازیابی میشود | اطلاعات داخل وزنهای مدل ذخیره میشود |
| بهروزرسانی آسان | برای تغییر اطلاعات باید دوباره مدل را آموزش داد |
| مناسب اسناد و دانش متغیر | مناسب تغییر رفتار یا سبک مدل |
امروزه بسیاری از سیستمهای پرسشوپاسخ سازمانی، چتباتهای پشتیبانی، دستیارهای حقوقی و پزشکی، و حتی موتورهای جستجوی مبتنی بر هوش مصنوعی از RAG استفاده میکنند. اگر قصد ساخت یک چتبات بر اساس اسناد خودتان را داشته باشید، RAG معمولاً اولین و بهترین گزینه است.
دیدگاهتان را بنویسید